1. O número, e por que o número não é o ponto
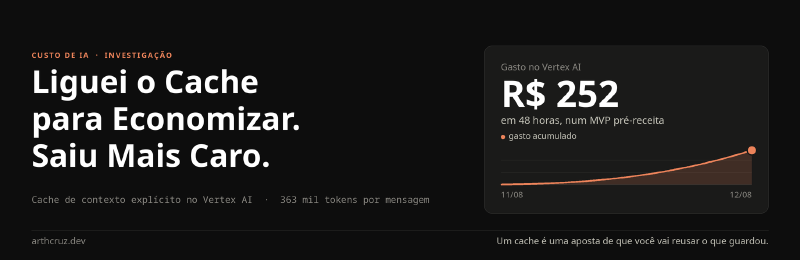
Ao longo de 11 e 12 de agosto de 2026, minha conta do Vertex AI subiu R$ 252. O detalhe que faz a diferença: o produto era um MVP que ainda nem faturava, com um punhado de pessoas testando na mão. Praticamente ninguém estava usando.
O que fazia aquilo valer uma investigação não era o tamanho do número, era o gasto ter se descolado do uso. Uma conta que acompanha o tráfego é o caso tranquilo: com quase ninguém usando o produto ela fica perto de zero, e qualquer coisa que a faça subir tem uma causa que dá para apontar. Essa estava subindo com praticamente ninguém usando. Alguma coisa me cobrava no ritmo dela, não no meu, e como eu não sabia o quê, também não tinha como saber onde aquilo ia parar.
A causa era um cache. Especificamente, um que eu tinha ligado para testar uma ideia, que passou no teste, e que eu depois esqueci que continuava ligado.
2. O que o sistema estava fazendo
O produto é um chat commerce para supermercados, da Tela Azul. Você escreve algo como “churrasco para 10 pessoas” e ele monta o carrinho: produtos reais, ids reais, preços reais, de um catálogo com cerca de 9 mil itens.
Essa última restrição é todo o problema de desenho. O modelo não pode inventar produto. Ele tem que escolher do catálogo, pelo id, porque os nomes repetem (o mesmo produto aparece em promoção e fora dela). A primeira versão funcional resolveu isso da forma mais direta possível: mandar o catálogo inteiro em cada requisição.
Comprimido, o catálogo inteiro dava aproximadamente 363 mil tokens de entrada por mensagem. Funcionava, e a precisão era boa, porque o modelo via de fato todas as opções entre as quais escolhia. Mas 363 mil tokens de entrada por mensagem não é um número que dá para deixar como está.
3. Por que eu liguei o cache
O Vertex AI suporta cache de contexto explícito: você sobe o conteúdo uma vez, recebe de volta um handle cachedContent e referencia esse handle nas requisições seguintes em vez de reenviar o conteúdo.
O raciocínio parecia à prova de balas. O catálogo é idêntico de uma requisição para a outra. Pague aqueles 363 mil tokens uma vez, aponte para eles depois, pare de pagar por mensagem. O código ganhou um segundo modo exatamente para isso, com o inline como fallback:
export type CatalogContext =
  | { mode: 'cache'; cachedContent: string; /* ... */ }   // preferencial
  | { mode: 'inline'; systemInstruction: string; /* ... */ };
Liguei como experimento, não como decisão fechada, e o que o experimento checava era comportamento: se o modelo continuava escolhendo bem com o catálogo num cache em vez de dentro da mensagem. Continuava. As respostas se sustentaram. Aí parti para a próxima coisa e deixei ligado, sem nunca conferir a outra metade, que era o que o cache estava fazendo com a conta.
Essa é a parte da história que importa. Uma feature flag fica parada esperando por você. Um cache explícito não: ele tem um taxímetro rodando, e o meu seguiu rodando por dias enquanto eu estava ocupado com outra coisa.
Quero ser preciso sobre o erro aqui, porque não foi um erro de código. O código fez exatamente o que eu mandei. O que estava errado era meu modelo de como a funcionalidade é cobrada, e quanto tempo eu deixei aquilo ligado sem olhar depois que o teste já tinha me dado a resposta.
4. Como o cache explícito é cobrado de verdade
Um cache explícito não é um desconto. É um aluguel, e tem três linhas separadas:
| linha | quando você paga | o que determina o valor |
|---|---|---|
| criação | toda vez que um cache é criado | os tokens que você coloca dentro, cobrados uma vez ao preço de entrada normal (aqui: 363 mil deles) |
| armazenamento | por hora de vida do cache | tokens guardados × tempo de relógio, proporcional ao minuto, com ou sem alguém lendo |
| leitura | em cada requisição que referencia o cache | com desconto forte em relação ao token de entrada normal |
Meu modelo mental era: pagar uma vez para criar e depois ler barato o bastante para o catálogo deixar de ser custo por mensagem. Duas coisas estavam erradas nele. Criação não era uma vez só, e a linha de armazenamento não existia no modelo. A leitura com desconto, a única das três que as comparações costumam mencionar, era a parte que eu tinha certa.
Vale reler a linha do armazenamento: ela é cobrada por hora de vida do cache, independente de tráfego. Um cache explícito com 363 mil tokens custa de armazenamento a mesma coisa às 4 da manhã, com zero requisição, e sob carga.
5. A investigação, e para onde olhei primeiro
O budget alert que eu tinha configurado em R$ 100 disparou primeiro. Ele me disse que o total tinha se mexido, que é a única coisa que um limiar sobre uma soma consegue dizer, então abri a página de billing do GCP para ver o formato daquilo. O que estava lá não era um total, era uma curva: o gasto diário subindo a um ritmo que não fazia sentido para a quantidade de gente usando o app, e subindo havia dois dias. A essa altura o cache tinha deixado de ser uma coisa em que eu pensava, então ele nem passou pela minha cabeça como suspeito.
Minha primeira suspeita foi voz, e continuo achando que era o primeiro palpite razoável. O text-to-speech é de longe o item mais caro do sistema: o áudio de saída era cobrado a cerca de US$ 10 por 1M de tokens quando eu medi isso, uma ordem de grandeza acima de qualquer outra coisa na stack, e o custo escala com o comprimento do texto que o cliente manda. Tanto /api/tts quanto /api/transcribe aceitavam payload do cliente sem teto de tamanho, sem autenticação e sem nenhum conceito de sessão no app. Se algo fosse torrar dinheiro nesse sistema, era esse o candidato. Rate limit não salva ninguém quando uma única requisição pode carregar 50 mil caracteres.
Então fui ao log de eventos. O log não respondeu nada.
O backup de 13 de agosto tinha 424 eventos gravados, todos eles kind: 'chat'. Nenhum evento tts e nenhum transcribe jamais havia sido registrado, porque esses caminhos nunca foram instrumentados. Eu não conseguia confirmar a hipótese da voz e também não conseguia matá-la.
Essa ausência já era a descoberta. Eu tinha um custo que não conseguia atribuir, num sistema em que o único caminho medido era o barato.
O que eu conseguia medir era texto: R$ 0,0180 por mensagem, apurado em 13–14 de agosto. Multiplique isso por qualquer número plausível de mensagens de um punhado de testadores manuais e você não chega perto de R$ 252. O dinheiro não estava na conta de tokens por mensagem. Algo estrutural estava me cobrando.
6. O mecanismo: criações empilhadas, armazenamentos sobrepostos
Quando parei de olhar volume de requisição e passei a olhar o ciclo de vida do cache, resolveu.
O “uma vez” que eu tinha na cabeça era ficção. Caches estavam sendo criados muito mais vezes do que eu supunha, e cada um seguia cobrando armazenamento até seu TTL expirar. Dois custos se compondo:
- Criação, repetidamente. A criação do cache é cobrada ao preço de entrada normal, ou seja, escrever 363 mil tokens num cache custa exatamente o que custaria ter mandado esses 363 mil tokens inline. Crie um por mensagem e você pagou a conta original inteira, e ainda comprou armazenamento mais uma leitura com desconto em cima dela. O cache nunca estava substituindo o custo antigo, estava somando a ele.
- Janelas de armazenamento sobrepostas. Vários caches do mesmo catálogo vivos ao mesmo tempo, cada um alugando espaço por hora até expirar.
Por requisição, o desconto era real. Ao longo dos dois dias, ele nunca chegou. O cache não amortizou o catálogo, ele o multiplicou, e mudou a cobrança para uma linha que ninguém estava lendo.
Vale dizer que tipo de falha é essa, porque ela mudou como eu penso controle de gasto. Nenhum rate limit de aplicação teria pegado isso. O relógio de armazenamento por hora roda enquanto ninguém está fazendo requisição nenhuma. Teto por IP, teto por rota, toda a caixa de ferramentas que eu desenhei depois: nada disso vigia um cache ocioso. Um teto global teria limitado as criações, e é por isso que ele continua na lista; mas a metade da conta que era armazenamento era invisível para a lógica de aplicação por construção.
7. A correção não foi um cache melhor
Eu podia ter ajustado o TTL. Podia ter garantido que um único handle fosse reaproveitado. As duas coisas reduziriam o número sem tocar no motivo de ele existir.
A leitura honesta é que o cache estava compensando o desenho. 363 mil tokens por mensagem não é um problema de cache. É um problema de “você está mandando seu banco de dados inteiro para o modelo”, e cachear isso só deixa a conta mais silenciosa.
Então o catálogo parou de ir ao modelo. No lugar, uma recuperação em duas etapas:
- Planner (Flash-Lite, barato) transforma a mensagem num plano de carrinho estruturado: itens canônicos, quantidades, termos de busca, filtros.
- Aterramento resolve cada item planejado no catálogo do Postgres, por similaridade vetorial mais casamento lexical, produzindo um pool de 150 a 600 produtos, equilibrado por construção, de modo que todo item planejado tenha candidatos nele.
Só o pool chega ao modelo.
Cortar um catálogo para algumas centenas de candidatos é uma aposta em recall, então isso não foi para produção só com o número de custo na mão. A mudança foi medida contra uma bateria automatizada de sessões de compra roteirizadas, rodada várias vezes contra os dois desenhos, e os carrinhos que ela produzia tinham que se sustentar diante dos antigos antes de a economia valer alguma coisa.
| antes | depois | |
|---|---|---|
| catálogo enviado por mensagem | ~9 mil produtos, ~363 mil tokens | pool de 150–600 produtos |
| tokens de entrada da síntese | ~363.000 | ~5.374 |
| cache explícito | estava lá para isso caber no bolso, e não estava cabendo | removido |
Um pool de algumas centenas de produtos é barato o bastante para ir inline em toda requisição, então o modo 'cache' virou código morto (nada o lia) e foi removido junto com a própria criação do cache. O comentário que ficou no lugar é este post inteiro em cinco linhas:
Só existe um modo. Havia um segundo,
'cache', do desenho anterior, em que o catálogo INTEIRO ia ao modelo e era estacionado numcachedContentpara não pagar 363 mil tokens de entrada por mensagem. O retrieval tornou aquilo obsoleto: hoje vai só o POOL recuperado (150 a 600 produtos), que é barato o bastante para seguir inline. O modo'cache'virou código morto (nada o lia) e foi removido junto com a criação do cache, que cobrava armazenamento por hora.
8. Nem todo cache é cache explícito
Vale separar uma coisa antes das conclusões, porque a lição deste post não é “cache é ruim”.
O que me custou dinheiro foi um cache explícito: conteúdo que eu subi de propósito, um handle que eu segurava, armazenamento que eu alugava por hora. Existe também o cache implícito, em que o provedor reaproveita sozinho um prefixo que se repete entre requisições. O token cacheado custa uma fração do token de entrada normal, nada é armazenado em seu nome e não existe linha por hora na fatura. Você não configura, e também não tem como esquecer ligado. Ou você dá a ele um prefixo estável, ou não dá.
Essa diferença é toda a distância entre os dois caches desta história. O que eu configurei e esqueci me cobrou por relógio. O outro não dá para deixar ligado sem querer, porque não há nada para deixar ligado. Quanto o implícito vale de verdade, depois de reorganizar o prompt para ele conseguir trabalhar, é uma história que eu conto em um outro post.
9. O que faltava de verdade: atribuição, não alarme
A mudança de código não foi a correção real. Dois dias depois do incidente eu escrevi o estado do sistema:
- nenhum rate limit em rota nenhuma, só retry em 429
- nenhuma autenticação, nenhum cookie, nenhuma sessão, nenhum conceito de usuário
/api/ttse/api/transcribeaceitando payload ilimitado do cliente- nenhum registro, por chamada, de qual classe de custo ela era
O contexto importa aqui, porque sem ele essa lista parece negligência. Isso nasceu como projeto de hackathon, feito para ganhar um. Nessa etapa a única coisa que conta é o produto funcionando de ponta a ponta, na frente dos jurados, no prazo. Rate limit, autenticação e quota por usuário não foram esquecimento, foram deliberadamente deixados para depois. E também não são controles que se desenham no vácuo: os tetos que fazem sentido dependem de qual cliente está para assinar e de como é o tráfego dele, e nada disso existia em agosto. Adiar foi a decisão certa e eu tomaria de novo.
Uma coisa não faltava, e é por isso que eu descobri em dois dias em vez de no fim do mês: eu tinha budget alert configurado, em R$ 100, e ele disparou. Ele fez exatamente o que um budget alert faz, e exatamente nada além disso. Ele me disse que o total tinha cruzado uma linha. Não tinha como me dizer qual linha.
Isso é um fato sobre o alerta que eu tinha configurado, não sobre a ferramenta. Budget pode ser escopado por projeto, por serviço ou por conjunto de labels, e o billing export para o BigQuery quebra o gasto por SKU. O meu era um limiar único sobre o total da conta, que é o que se configura quando você quer saber que algo está errado e ainda não decidiu sobre o que vai querer saber.
Essa lacuna é a lição inteira. Alerta é um limiar sobre uma soma, então a única ação que ele consegue sugerir é a grossa: sair desligando coisa até o número parar de subir.
Escolhi não fazer isso, e duas coisas transformam essa escolha em conta, não em bravata. O gasto estava dentro do que eu conseguia absorver, por mais desagradável que fosse ver aquilo subindo, e eu tinha um segundo número na cabeça a partir do qual derrubaria tudo independentemente do quanto já tivesse descoberto. E, mais importante, o app não estava em produção. Ninguém dependia dele, nenhum cliente notaria nem o gasto nem uma parada, e o único exposto ali era meu próprio dinheiro. Nessas condições, deixar rodando era a forma mais barata de comprar evidência, porque desligar levaria embora o sintoma junto com todo rastro da causa.
Em produção essa conta se inverte, e vale dizer isso com todas as letras, porque a decisão certa aqui é a errada lá. Se foi uma subida que começou a escalada, a primeira ação é rollback imediato, antes de qualquer diagnóstico: você restaura o comportamento conhecido, estanca o gasto e reproduz o problema num ambiente em que estudar sai quase de graça. Investigar no sistema vivo é para quando rollback não é opção, e enquanto você investiga está pagando por evidência por hora. Eu fiz a metade do diagnóstico e pulei a metade do rollback por um motivo nada glamoroso: não havia ambiente de produção para onde voltar.
O que teria transformado essa investigação numa consulta é justamente o que eu não tinha: classe de custo gravada em toda chamada. Com chat, tts, transcribe e criação de cache etiquetados e precificados, a resposta é um GROUP BY. Sem isso, o que eu tinha era um número subindo e um sistema com um caminho instrumentado de quatro.
A ordem que eu escolhi para quando esses controles forem construídos não é, de propósito, a ordem que parece natural:
- Teto de tamanho antes de teto de frequência. Rate limit não limita custo quando o payload é ilimitado: “10 por minuto” ainda permite dez requisições de 50 mil caracteres cada. Teto de tamanho é stateless, não precisa de contador compartilhado nem de decisão sobre chave de identidade, e limita o pior caso de cada requisição isoladamente. Calibre baixo demais e ele recusa entrada legítima, que é problema de calibragem e se resolve com um número. O que ele nunca faz é recusar uma requisição por causa do tráfego de outra pessoa, que é a falha embutida em todo teto de frequência. Meia hora de trabalho.
- Classe de custo em toda chamada. O alerta te dá um total; isso te dá a quebra que torna o total acionável. É uma coluna, não um sistema, e é o que separa “o gasto subiu” de “o gasto subiu porque a criação de cache rodou 400 vezes”.
- Medir os caminhos não medidos, uma chamada real de TTS e uma de STT com o log ligado, para calibrar tetos com número em vez de palpite.
- Teto global por classe de custo, guardado no Postgres e não em memória (em serverless as instâncias vão e vêm, então contador em memória vaza limite de forma aleatória), com kill switch desde o primeiro commit, senão a bateria de qualidade passa a bater no próprio teto.
- Teto por IP, generoso. Uma demonstração em que um time inteiro testa na mesma sala é o pior caso para limite por IP, e wifi corporativo e CGNAT fazem a mesma coisa. E é fraco do outro lado: trocar de IP é barato para quem quer abusar.
Repare que os passos 1 e 2 são os itens mais baratos da lista e nenhum dos dois é uma funcionalidade. A parte cara deste incidente não foi construir nada, e também não foi alarme faltando. Foi ter um alarme que só conseguia dizer que o dinheiro estava saindo, num sistema que não conseguia dizer por onde.
10. Lições aprendidas
Um experimento que você deixa ligado para de ser experimento. Liguei o cache por um motivo de custo e validei por um critério de qualidade: as respostas estavam boas, então ficou. São duas perguntas diferentes, e nada no sistema me obrigou a perceber que eu só tinha respondido uma delas. Qualquer coisa que você liga para experimentar precisa terminar o dia com uma decisão ou com prazo de validade, e essa decisão tem que ser medida contra o motivo que fez você ligar.
Um cache é uma aposta de que você vai reusar o que guardou. Cobrada por hora, você paga por essa aposta enquanto ela durar. Se o reuso não acontece, ou se a coisa guardada fica sendo substituída, você paga aluguel de algo que ninguém lê.
Cache não é correção para enviar dados demais. Na melhor das hipóteses ele muda a conta de lugar, e no meu caso ele somou a ela. Se o número que você está prestes a cachear é absurdo, o número é o bug e o cache é o sintoma.
Leia a página de preço da funcionalidade, não só a do modelo. Preço por token é o que todo mundo compara. Meu dinheiro saiu por criação de cache e armazenamento por hora, duas linhas que nunca aparecem numa tabela de comparação de modelos.
Alarme não é instrumentação. O budget alert fez o trabalho dele e avisou que o total tinha se mexido. Atribuição é outra funcionalidade, e essa eu não tinha: 424 eventos gravados, todos do caminho mais barato, nada registrado nos três caminhos que podiam plausivelmente ser o caro. Limiar sobre soma manda você entrar em pânico. Quebra por SKU diz pelo que o provedor cobrou. Só o registro das suas próprias chamadas diz qual parte do seu produto fez aquilo.
Prefira o cache que você não precisa configurar. O implícito não precisa de configuração e não gera linha de armazenamento nenhuma, que é justamente a linha que me pegou aqui. Cache explícito é para conteúdo realmente grande, realmente estável e realmente lido muitas vezes antes do TTL expirar. E você deveria conseguir dizer qual dessas três coisas você mediu.
Gasto que não acompanha o uso é pior que gasto alto. R$ 252 é pouco. R$ 252 em 48 horas sem ninguém usando quer dizer que a conta parou de depender de mim, e o que eu não controlo eu também não sei dimensionar.
11. Conclusão
A versão curta dessa história é que eu liguei um cache para testar, as respostas saíram boas, eu esqueci dele, e ele me cobrou por hora até eu perceber. A versão útil é que o cache nunca foi o problema real: o problema era um desenho que mandava 363 mil tokens por mensagem, e o motivo de isso levar dias em vez de minutos para ser achado é que o alerta sabia dizer que o total tinha se mexido, e nada no meu próprio sistema sabia dizer o que tinha mexido.
Adotar essas APIs significa adotar um modelo de cobrança que a maioria de nós ainda não internalizou, e que é mais largo que o modelo de linguagem em si: a mesma fatura carrega armazenamento, criação de cache, áudio de saída e texto de saída, precificados em escalas completamente diferentes, e o erro mais barato possível é o que você percebe em uma hora em vez de uma semana. Um budget alert vai te dizer que o dinheiro está saindo. Decidir, no primeiro dia, gravar quanto cada chamada custou e por quê é o que te diz para onde ele foi.